Base di conoscenza con risposte citate
Un sistema che raccoglie norme, documenti e notizie dai siti istituzionali, li indicizza e risponde alle domande indicando da quali documenti nasce ogni affermazione. L'ho sviluppato nell'azienda di software in cui lavoro come sviluppatore, per un ente portuale. Il nome dell'ente non è citato.
A cosa serve e cosa può fare
Per un ente pubblico che deve ritrovare norme e notizie sparse su molti siti istituzionali. ETT lo propone tra le sue soluzioni di intelligenza artificiale. Offre un unico punto di ricerca, con risposte verificabili sulla fonte.
- Raccoglie documenti e notizie dai siti istituzionali e li tiene aggiornati.
- Unisce ricerca per parole e ricerca per significato.
- Risponde in linguaggio naturale citando le fonti, da aprire e controllare.
- Pone un tetto alla spesa mensile per l'intelligenza artificiale.
- Misura la qualità delle risposte su un insieme di domande di prova.
Il contesto
Chi lavora in un ente portuale deve seguire norme, studi e notizie ambientali pubblicati su molti siti diversi, in varie lingue e formati. Le informazioni ci sono ma sono sparse. Serviva un posto solo dove cercare, con risposte di cui si possa controllare la provenienza.
Il progetto è in sviluppo da febbraio 2026: ne ho scritto la maggior parte, con un collega.
Raccogliere i documenti
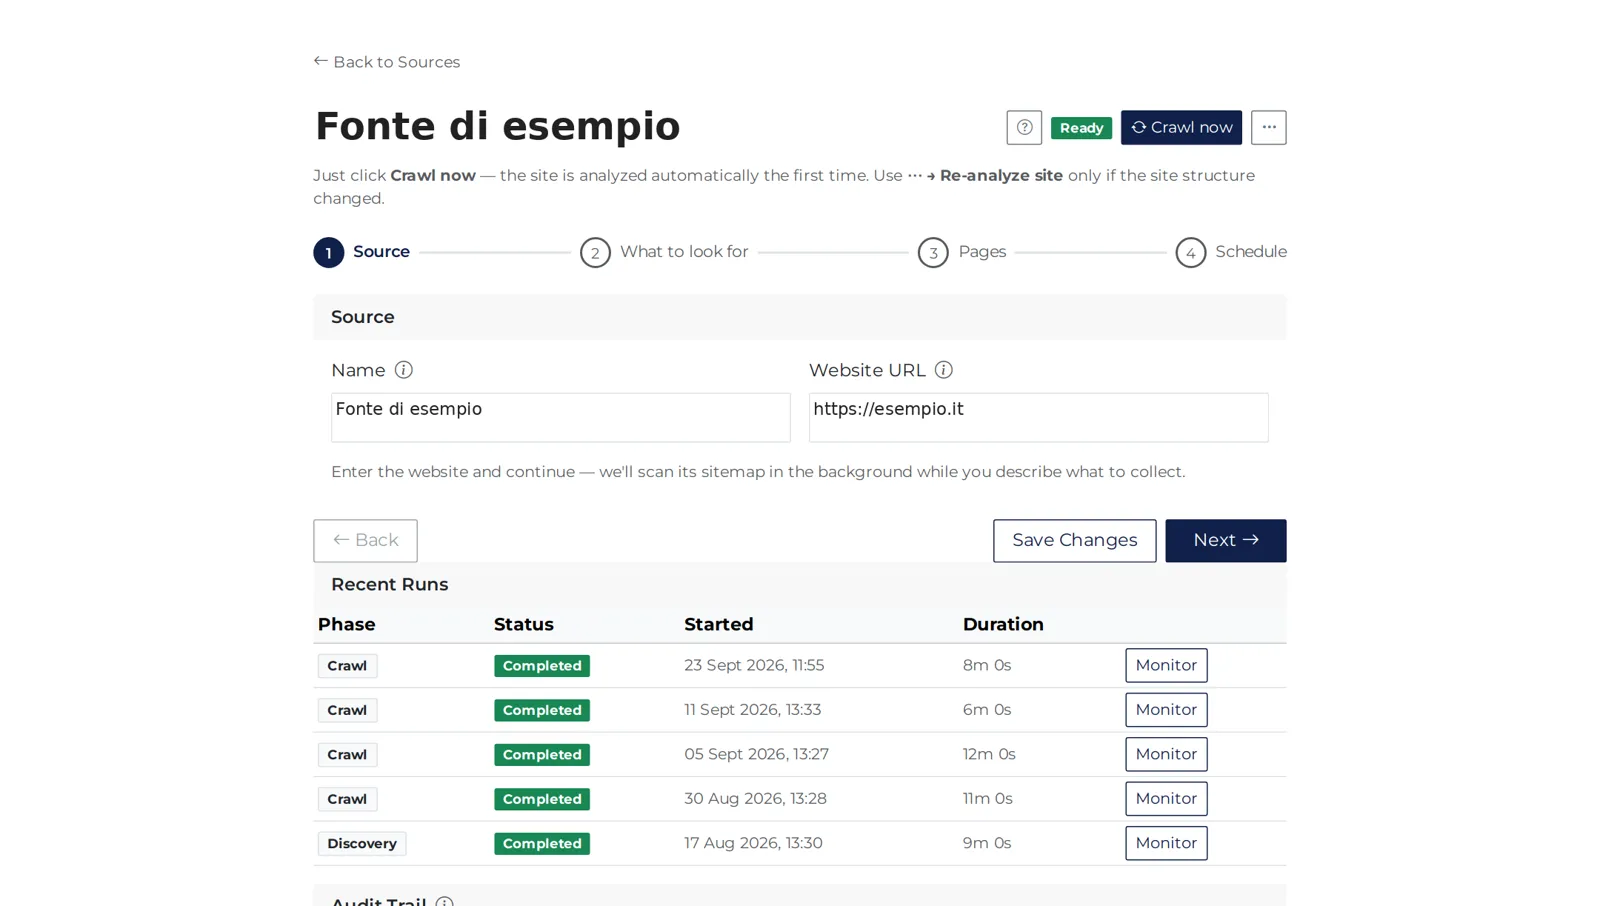
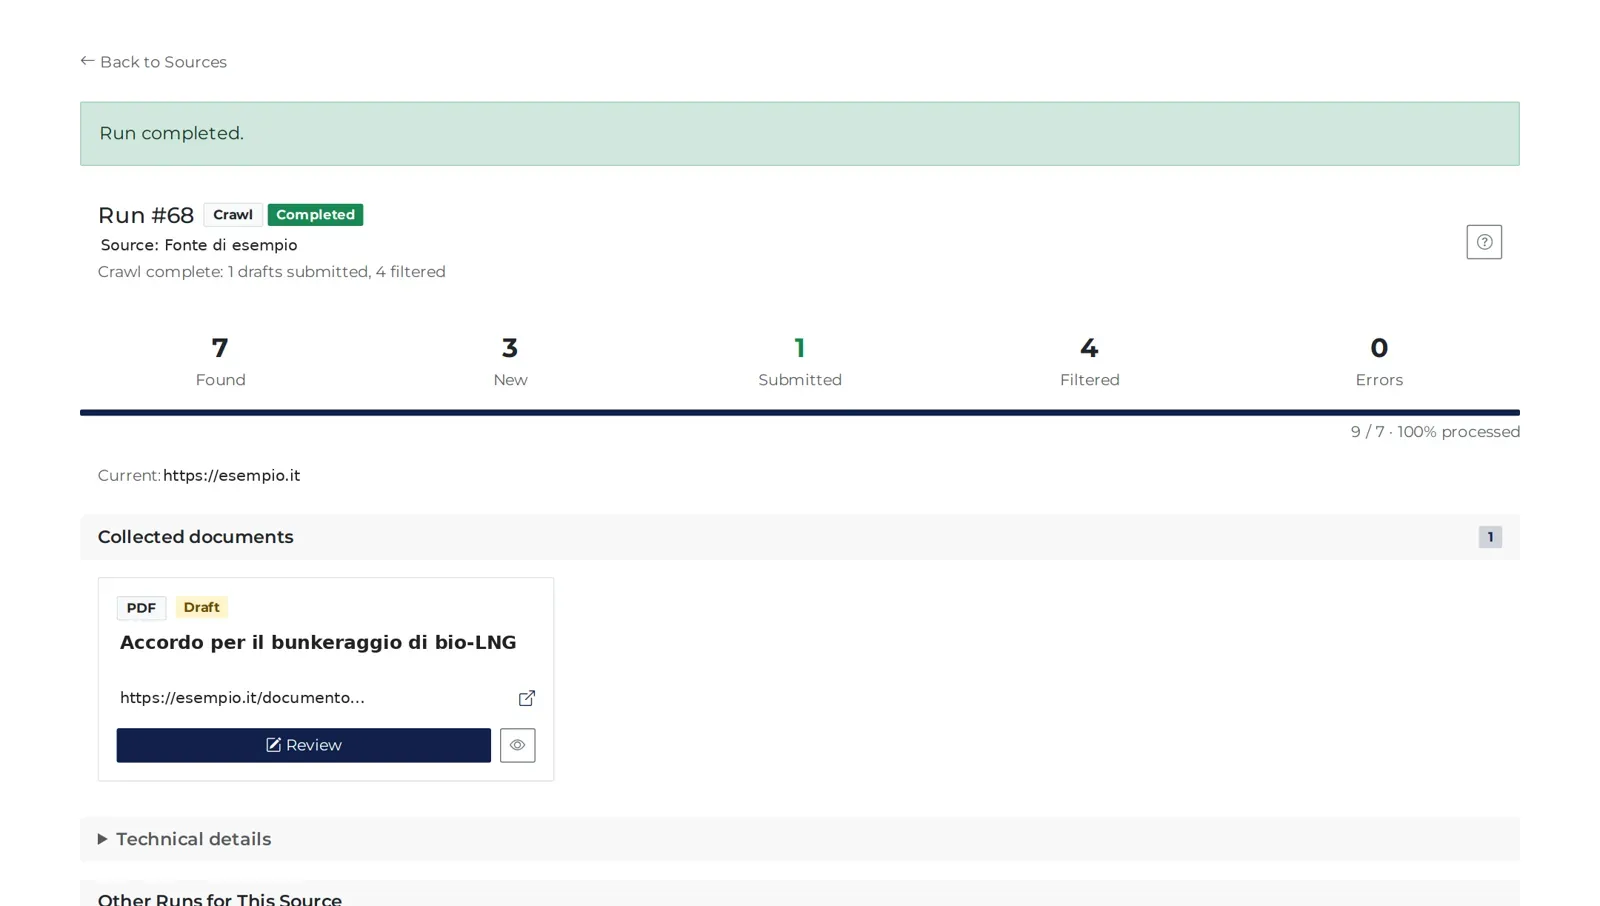
Il raccoglitore è un servizio a parte. Per ogni fonte (un sito, un feed RSS, una sezione di notizie) trova le pagine tramite sitemap e feed, e le apre con un browser vero, perché alcuni siti si difendono con controlli in JavaScript. Dalle pagine estrae il testo principale; PDF e documenti passano da Apache Tika.
Un modello linguistico aiuta a decidere quali pagine seguire e quali scartare perché non pertinenti. Le istruzioni per ogni sito vengono salvate e riusate, così la volta dopo non serve rianalizzarlo. I documenti trovati arrivano come bozza: li rivede una persona prima della pubblicazione. Le raccolte si ripetono a intervalli e un controllo evita di rielaborare pagine già viste.
Cercare e rispondere
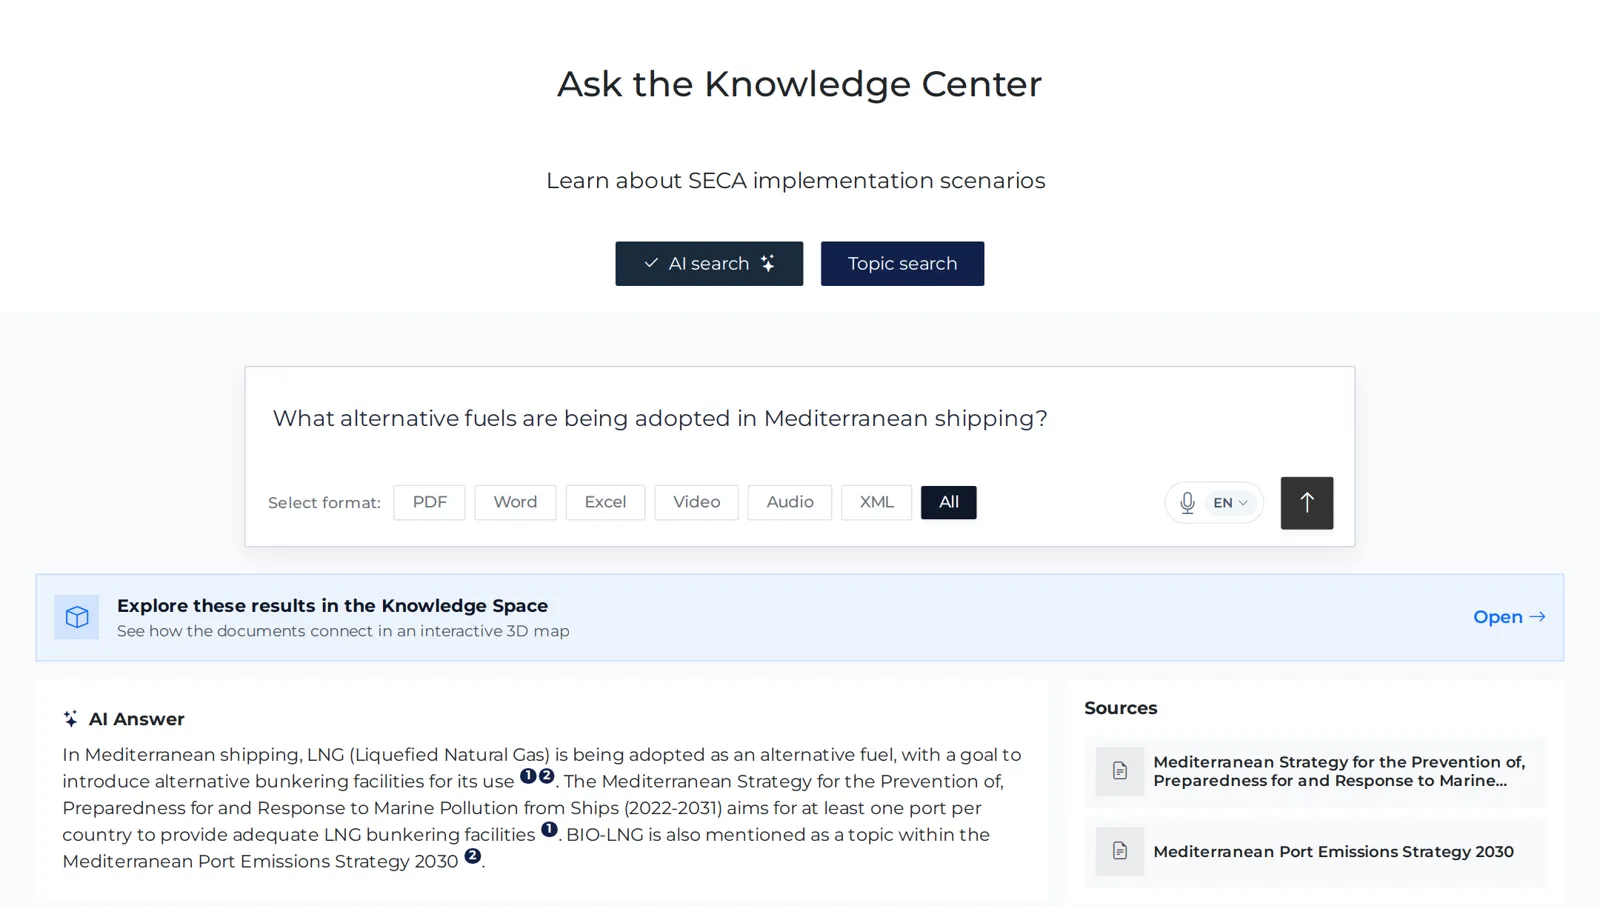
Ogni documento pubblicato viene diviso in pezzi di circa mille caratteri, con una sovrapposizione di 150 per non tagliare le frasi a metà. Per ogni pezzo si calcolano un vettore numerico di 768 valori (prodotto da un modello di embedding, con una cache per non ripagare testi già visti) e una rappresentazione per parole chiave (BM25). Tutto sta in Qdrant.
La ricerca è ibrida: unisce le due classifiche, così «attracco» trova anche «ormeggio» e un codice o una sigla esatta non si perde. Un passaggio facoltativo di riordino mette in cima i risultati migliori. Un modello più piccolo riscrive le domande di seguito («e quello?») prima della ricerca, in modo che la chat funzioni su più turni.
La risposta è scritta da un modello linguistico (Gemini) che riceve solo i pezzi trovati e deve citarli con un numero. Il sistema mostra solo i documenti citati davvero e la risposta arriva in streaming.
Come lo valuto
Una risposta che sembra giusta non basta, quindi c'è un piccolo sistema di valutazione. Un insieme di 19 domande con la risposta nota, divise in categorie (parole chiave, significato, più documenti, filtri, domande senza risposta), misura se i documenti giusti vengono trovati (recall, precisione, MRR, NDCG). Tre controlli automatici con un modello giudice valutano poi se la risposta è fedele ai pezzi, pertinente e completa. Prova la stessa catena che gira in produzione e permette di confrontare due configurazioni, per esempio con e senza riordino, sui numeri e non a sensazione.
Il carico l'ho provato con 10.137 documenti (17.220 pezzi in Qdrant, con vettori casuali per non spendere chiamate): la ricerca per testo passa da 160 ms a 308 ms a un utente alla volta. Con 50 utenti insieme la ricerca ha un tempo mediano di 1,9 s. Il collo di bottiglia erano le connessioni al database, non i dati.
Cosa ho fatto io
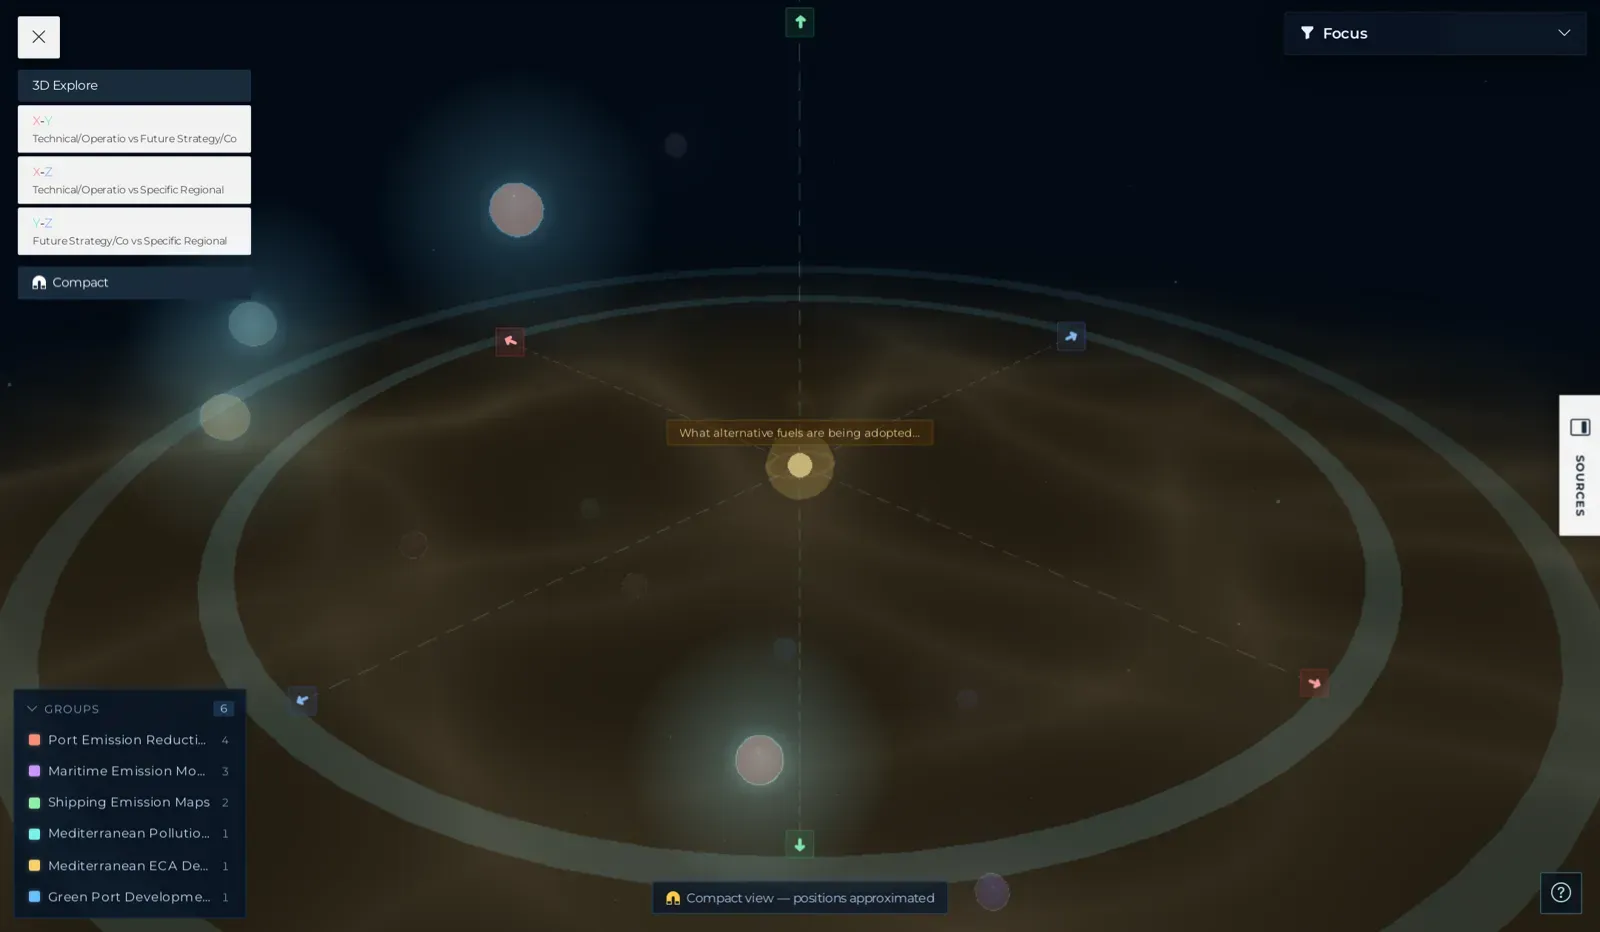
Il servizio di ricerca e risposta, il raccoglitore, la parte Django che li collega e gran parte dell'interfaccia, compresa la mappa 3D costruita con three.js. Ho scritto anche i test (503 nella suite del backend a settembre 2026), le prove di carico e di compatibilità dei browser e la documentazione per il cliente. Dal 2026 il servizio gira su un server di prova dell'ente.
Limiti e stato
Il sistema è in fase di prova su un ambiente di staging, non ancora in produzione piena. La valutazione ha solo 19 domande: serve a notare i peggioramenti, non a dare una percentuale di correttezza. Le risposte dipendono da un servizio esterno a pagamento, con un tetto di spesa mensile e la possibilità di cambiare fornitore. L'estrazione dei sottotitoli dei video è spenta per prudenza legale. Il progetto è dell'azienda e non è pubblico.
Tecnologie
Python, Django, FastAPI, Celery, PostgreSQL con PostGIS, Qdrant, Redis, Playwright, Apache Tika, Nuxt (Vue, TypeScript), three.js, Docker.